
标签: DeepSeek DeepSeek-OCR 2 OCR模型 文档识别
 我要评论
云梦级1月27日云梦级消息,DeepSeek 今日公布了其最新一代文档识别模型 DeepSeek-OCR 2。很显然,该模型是在 DeepSeek-OCR 的基础上升级而来,核标签心变化集中在视觉编码器设计上。
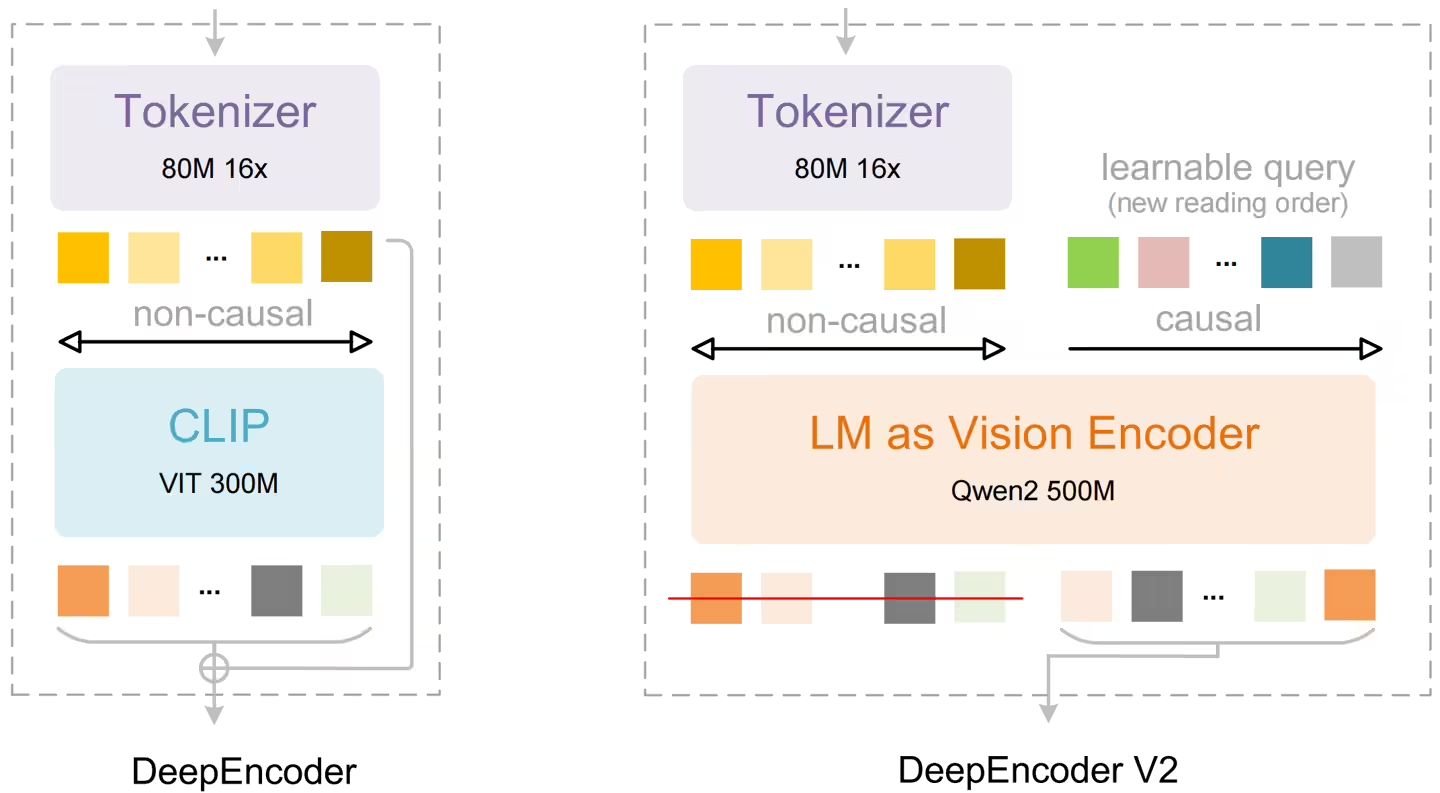
研究团队提出了一种名为 DeepEncoder V2 的新型编码器结构,它能够根据图像语义动态调整视觉信息的处理顺序,使模型在进行文字识别前先对: 视觉内容进行智能排序。这项技术突破源于对传统视觉语言模型处理方式的重新思考,旨在让机器更贴近人类的视觉阅读逻辑。
在传统的视觉语言模型中,图像通常会被切分为若干视觉 token,De并按照从左上到右下的固定栅格顺序送入模型处理。这种方式虽然实现简单,但与人类在阅读文档、表格或公式时基于语义和逻辑关系进行跳跃式浏览的方式并不一致。
DeepSeek 论文指出,尤ep其在版式复杂的文档场景中,视觉元素之间往往存在明确的逻辑先后关系,仅依赖空间顺序可能限制模型对内容结构的理解能力。
DeepSeek-OCR 2 的改进重点在于引入“视觉因果流”的Se概念。在 DeepEncoder V2 中,研究团队用一种类语言模型结构替代了原先基于 CLIP 的视觉编码模块,并在编码器内部引入可学习的“因果流查询 token”。
其编码器同时包含双ek向注意力与因果注意力两种处理模式,原始视觉信息通过双向注意力进行全局感知,而新增的查询标记则通过因果注意力逐步建立语义顺序,从而在编码阶段对视觉 token 的顺序进行动态 D重排。最终,只有经过因果重排后的查询 token 会被送入后续的解码器,用于生成识别结果。
在整体架构上,DeepSeek-OCR 2 仍沿用了前代模型的编解码框架。编码器将图像ee转换为视觉标记并进行压缩,被压缩为较少数量的视觉 token,再由 DeepEncoder V2 进行语义建模和顺序重组,最后交由一个基于混合专家架构(MoE)的语言模型解码。
DepSepSeek 论文指出,该设计在不显著增加解码负担的前提下,将单页文档所使用的视觉 token 数量控制在 256 到 1120 之间,与前代模型及同类系统的资源开销保持在相近水平ee。
为验证模型性能,研究团队在 OmniDocBench v1.5 基准上进行了全面评估。该基准涵盖多种类型的中英文文档,包括学术论文、杂志、报告等,重点考察文本识别、公式解析、表格结k-构还原以及阅读顺序等指标。
测试结果显示,在视觉 token 上限更低的情况下,DeepSeek-OCR 2 的整体得分达到 91.09%,相较 DeepSeek-OCR 提升了 3.73%OC。特别是在阅读顺序准确度方面,编辑距离从 0.085 降至 0.057,表明新模型能够更合理地理解文档内容结构。
DeepSeek-OCR 2 在生产环境中也表现出更好的稳定性。在线用户日R 志图像的重复率从 6.25% 降至 4.17%,批处理 PDF 数据的重复率从 3.69% 降至 2.88%。这些改进使得模型在保持高压缩率的同时,提升了实际应用场景中的可靠性。
相关文章
苹果App Store新规12 月 8 日起实行,规范开发者的隐私信披义务
苹果App Store新规12 月 8 日起实行,规范开发者的隐私信披义务 12月8日起,苹果用户下载APP之前,都可以先了解到该APP的隐私保护做法。 日前,苹果向开发者发出特别提醒:用户在任何Ap2026-11-16 在传统的搜索引擎优化(SEO)时代,内容是为了“被人找见”而写的。如今,随着人工智能(AI)、大语言模型(LLM)与生成式搜索(Generative Search)开始普及,内容不仅要“被人看到”,更2026-11-16
 近日,Meta 的人工智能研究团队推出了一款名为代码世界模型(Code World Model,简称 CWM)的大型语言模型。 这一新模型的推出,标志着代码生成技术的一个重大进步,它不仅学习代码的外观2026-11-16
 云梦级12月23日云梦级消息,据奇安信官方公众号透露,12 月 22 日 22 时许,国内知名短视频平台快手遭遇黑灰产猛烈攻击。在短短60到90分钟内,黑客组织通过技术手段侵入快手系统,导致整个平台安2026-11-16
 云梦级12月24日云梦级消息,12 月 22 日,闻泰科技董事长杨沐发声,指责荷兰政府针对安世半导体的司法行动违反中荷 2001 年投资保护协定,系与当地高管合谋驱赶合法股东的 “有预谋、无正当性干预2026-11-16
 云梦级12月11日云梦级消息,据蓝鲸汽车从相关渠道人士处了解到,目前江淮正对其乘用车板块经销商渠道体系进行整合,预计需要2-3个月,此前门店处于分品类经营,“之前MPV门店就只经营MPV,皮卡就只经营2026-11-16
最新评论